
Mục lục bài viết 8 phần
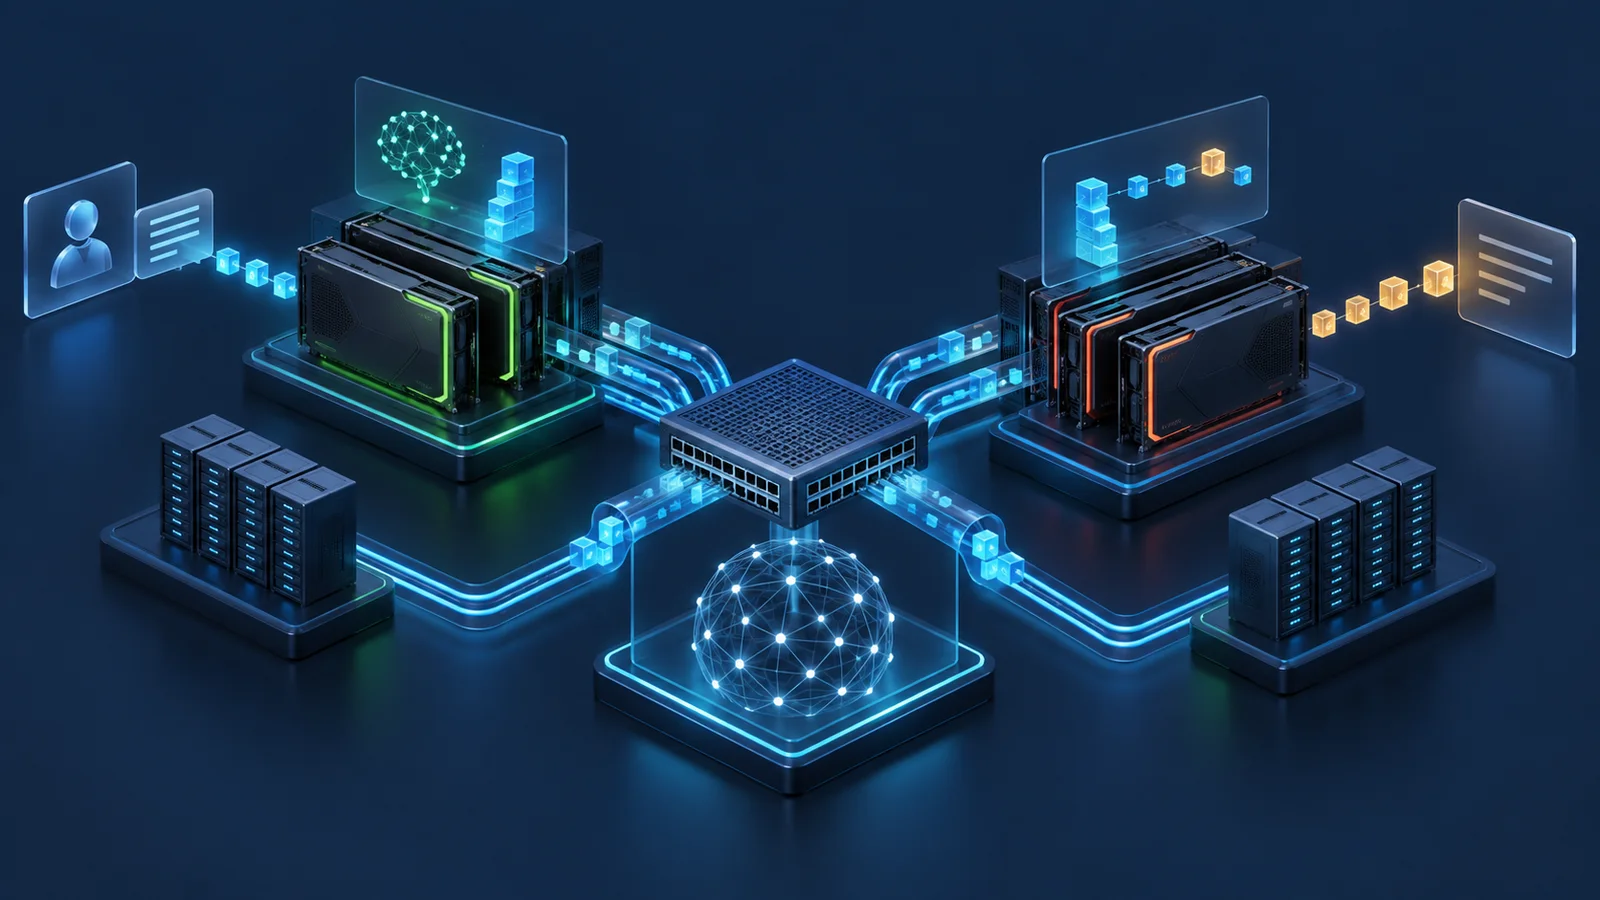
Ngày 21/09/2026, Cisco công bố kết quả MLPerf Inference v6.1 cho dịch vụ inference phân tán kết hợp NVIDIA H200 và AMD Instinct MI350X qua Ethernet fabric dùng Cisco Silicon One G200. Cisco báo cáo cấu hình kết hợp đạt 73.357,62 token/giây, tương đương 104,7% tổng số học của hai hệ thống đo riêng. Đây là kết quả có cấu hình và điều kiện cụ thể; không nên biến thành kết luận rằng mọi fabric đa hãng đều “không có penalty”.
Bài viết giúp bạn
- Thông tin được công bố
- Điểm mới đáng chú ý
- Tác động đối với kiến trúc, vận hành và kiểm thử
Thông tin được công bố
#Cisco cho biết submission MLPerf Inference v6.1 dùng tám NVIDIA H200 và tám AMD Instinct MI350X, nối qua fabric Ethernet dựa trên Cisco Silicon One G200. Dịch vụ phân tán dựa trên vLLM; trong bài chạy GPT-OSS 120B Server, nhóm H200 thực hiện prefill, nhóm MI350X thực hiện decode. NIXL với UCCL làm RDMA backend để chuyển KV cache giữa hai nhóm.
Theo Cisco, tổng throughput của hai hệ thống đo riêng là 70.085,48 token/giây; chạy kết hợp đạt 73.357,62 token/giây, tăng 3.272,14 token/giây, đồng thời đáp ứng giới hạn p99 TTFT và TPOT áp dụng trong benchmark. Các số liệu này là kết quả submission theo cấu hình công bố và cần đối chiếu trang kết quả MLCommons.
Điểm mới đáng chú ý
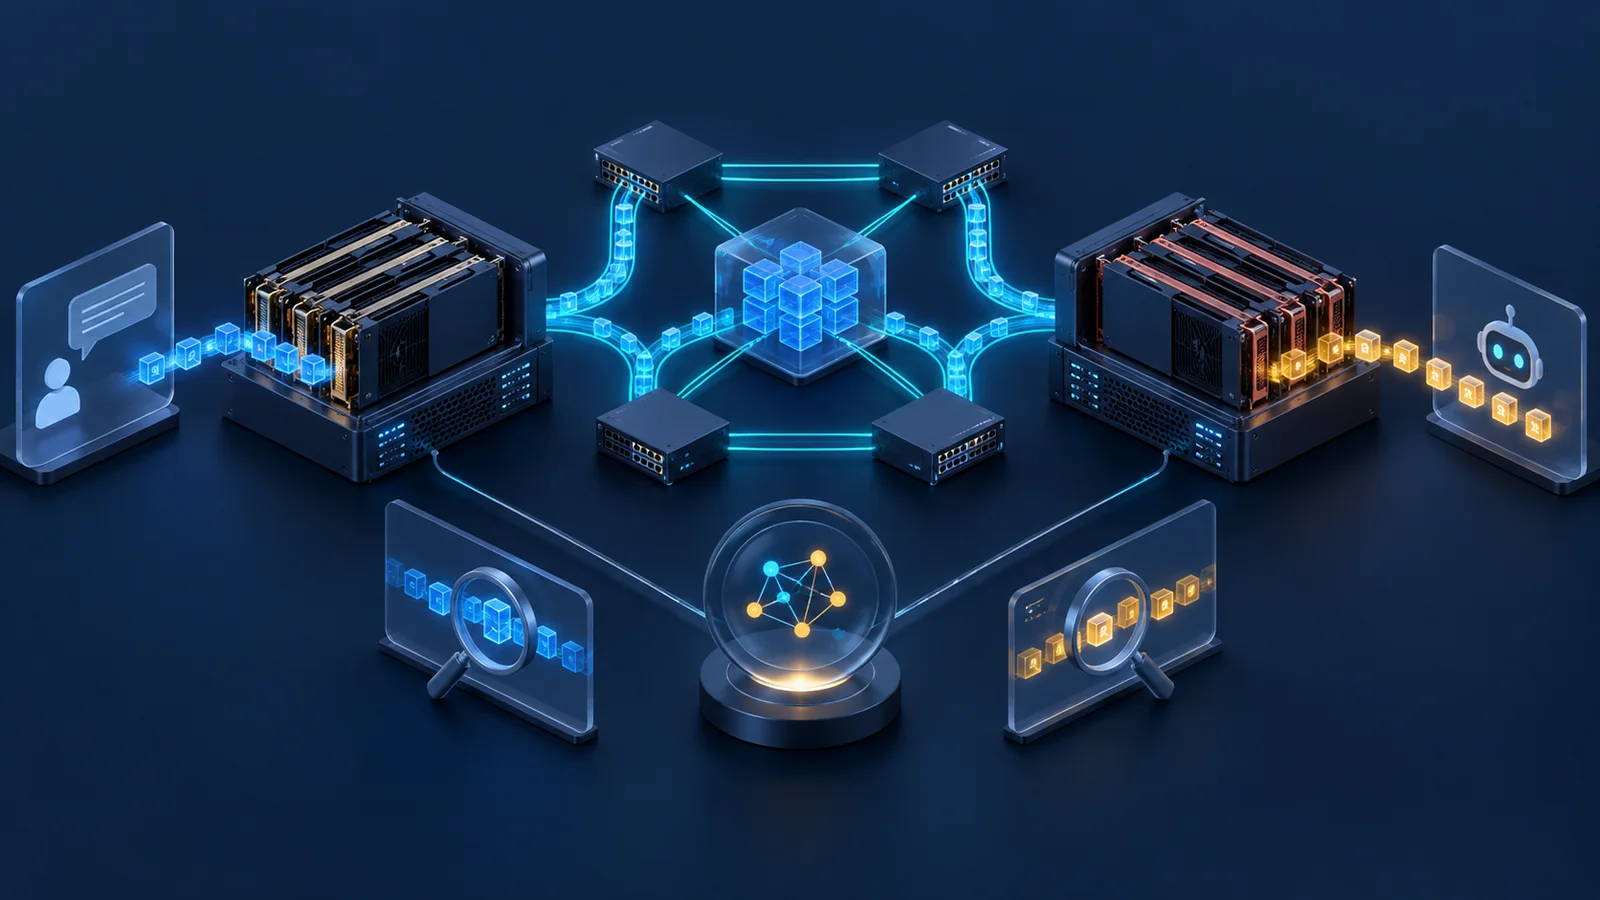
#Điểm kỹ thuật là prefill–decode (PD) disaggregation giữa accelerator của hai hãng. Prefill thiên về xử lý prompt và tạo KV cache; decode sinh token tuần tự và đọc model/KV cache. Việc tách hai pha cho phép scale độc lập nhưng biến fabric thành một phần trực tiếp của response path vì decode chờ KV state được chuyển tới.
Cisco gọi đây là submission MLPerf đa nhà cung cấp accelerator đầu tiên. Giá trị của benchmark là cố định model, dataset, accuracy target, load rules và latency limit theo scenario. Bài Cisco nêu Offline, Server và Interactive; kết quả 104,7% được nhấn mạnh cho GPT-OSS 120B Server và không nên áp sang mọi model/scenario.
104,7% của baseline tương ứng tăng khoảng 4,7%, không phải tăng 104,7%. Các con số chi tiết trong bài được quy thuộc báo cáo của Cisco; NetVali không tự đo lại submission này.
Tác động đối với kiến trúc, vận hành và kiểm thử
#Kiến trúc inference dị thể cần thêm scheduler/placement, compatibility của KV format, data path RDMA, congestion control và observability xuyên prefill–fabric–decode. Hệ thống phải quyết định khi nào giữ request trên một replica, khi nào tách pha, và xử lý thế nào khi một pool chậm hoặc không còn capacity.
KPI không chỉ là token/giây. Cần TTFT, TPOT, end-to-end latency, goodput đạt SLO, KV-transfer size/rate, network p99, queue/ECN/PFC nếu dùng, GPU utilization, scheduler queue, error/retry và cost/energy trên request. Tối ưu throughput có thể làm xấu interactive latency nếu traffic mix khác benchmark.
- Thành phần: Prefill pool · Điều cần kiểm chứng: TTFT, saturation, KV format · Bằng chứng: trace, GPU metric, request ID
- Thành phần: Ethernet/RDMA · Điều cần kiểm chứng: latency, throughput, congestion, loss · Bằng chứng: flow/queue telemetry, packet/counter
- Thành phần: Decode pool · Điều cần kiểm chứng: TPOT, cache read, tail latency · Bằng chứng: token timeline, GPU/RNIC metric
- Thành phần: Scheduler · Điều cần kiểm chứng: placement, fairness, fallback · Bằng chứng: decision log, queue time
- Thành phần: End-to-end · Điều cần kiểm chứng: accuracy, SLO, failure recovery · Bằng chứng: output validation, p99, error/retry
Ai cần quan tâm
#AI infrastructure architect, data center network, platform/SRE, ML serving, capacity planning và procurement cần quan tâm. Network team phải đo KV path; ML team xác nhận accuracy/serving stack; SRE kiểm failure/retry; tài chính đánh giá utilization và cost; procurement xác minh cấu hình, support và compatibility.
Doanh nghiệp có accelerator nhiều thế hệ hoặc nhiều hãng có thể dùng đây như một reference point để đặt câu hỏi, không phải business case hoàn chỉnh. Lợi ích tránh stranded capacity chỉ thành hiện thực nếu model, runtime, KV format, scheduler và fabric tương thích.
Những điểm chưa thể kết luận
#Không thể kết luận 104,7% là mức tăng chung cho mọi model, prompt length, output length, batch, arrival pattern hoặc topology. “No net penalty” là so với tổng số học của hai standalone measurement trong cấu hình nêu trên; không có nghĩa KV transfer không tiêu thụ network resource. Cisco nói chính transfer vẫn dùng tài nguyên nhưng phase placement bù được chi phí.
Bài công bố không tự chứng minh TCO, năng lượng, multi-rack behavior, failure recovery, congestion với workload khác hoặc performance khi KV format cần conversion. Leaf-local path cũng không đại diện mọi fabric nhiều hop. Mọi khả năng production phải được kiểm theo version của vLLM, NIXL, UCCL, driver, firmware và model.
Checklist hành động hoặc kiểm chứng
#- Mở submission MLCommons và ghi model, scenario, accuracy, system ID, software stack.
- Xác nhận số GPU, server, NIC/link, topology leaf-local và fabric config.
- Tái tạo standalone baseline bằng cùng rule, không dùng run khác điều kiện.
- Đo TTFT, TPOT, throughput và accuracy cùng lúc.
- Thu KV-transfer rate/size, RDMA counter, queue, ECN/PFC và link utilization.
- Thử prompt/output distribution giống production, không chỉ benchmark mix.
- Inject GPU/pool/link failure, scheduler fallback và congestion nền.
- Tính cost, power và operational complexity trên request hữu ích.
Test plan pilot đề xuất
#Pilot gồm ba baseline: H200-only, MI350X-only và combined PD, tất cả dùng cùng model, dataset, accuracy target, arrival model và latency SLO. Sau đó đổi prompt/output distribution theo production. Đo ít nhất p50/p95/p99 TTFT/TPOT, tokens/s đạt SLO, GPU/RNIC/network utilization và error.
- Ca: AI-01 · Điều kiện: Standalone từng pool · KPI: throughput, TTFT/TPOT · Câu hỏi pass/fail: Baseline tái lập được?
- Ca: AI-02 · Điều kiện: Combined PD · KPI: end-to-end + KV path · Câu hỏi pass/fail: Có lợi ích sau khi giữ SLO/accuracy?
- Ca: AI-03 · Điều kiện: Long prompt/short output · KPI: prefill/network · Câu hỏi pass/fail: Scheduler placement còn phù hợp?
- Ca: AI-04 · Điều kiện: Short prompt/long output · KPI: decode/queue · Câu hỏi pass/fail: Tail latency có vượt ngưỡng?
- Ca: AI-05 · Điều kiện: Link congestion/failure · KPI: recovery, retry · Câu hỏi pass/fail: Có fallback, mất request/duplicate?
- Ca: AI-06 · Điều kiện: Một pool saturation · KPI: fairness/capacity · Câu hỏi pass/fail: Có overload cascade?
Khái niệm cần nhớ
#- Prefill: Pha xử lý prompt và tạo KV cache, ảnh hưởng TTFT.
- Decode: Pha sinh token, ảnh hưởng TPOT.
- PD disaggregation: Tách prefill và decode sang serving group khác nhau.
- KV cache: State attention cần chuyển khi tách hai pha.
- TTFT/TPOT: Time to first token và time per output token.
- MLPerf Inference: Benchmark suite có rule về model, accuracy, load và latency.
- Superlinear result: Kết quả kết hợp vượt tổng số học baseline trong điều kiện đo; không phải quy luật chung.
Khái niệm cần nhớ
- DUT / SUT
- Thiết bị hoặc toàn bộ hệ thống đang là đối tượng của bài kiểm thử.
- Steady state
- Giai đoạn tải đã ổn định và đủ điều kiện để lấy số liệu đại diện.
- Pass / fail
- Kết luận dựa trên ngưỡng đã thống nhất, luôn đi cùng topology, cấu hình và điều kiện đo.
TÀI LIỆU ĐỐI CHIẾUTài liệu tham khảo3 nguồn +
Nội dung được biên soạn độc lập, theo hướng vendor-neutral và đối chiếu các tài liệu gốc dưới đây. Tính năng sản phẩm cần được kiểm tra lại theo phiên bản đang sử dụng.
NetVali ưu tiên nguồn tiêu chuẩn và tài liệu chính thức; phân biệt khuyến nghị triển khai với yêu cầu của tiêu chuẩn; không công bố thông số sản phẩm chưa gắn với phiên bản và điều kiện đo.