
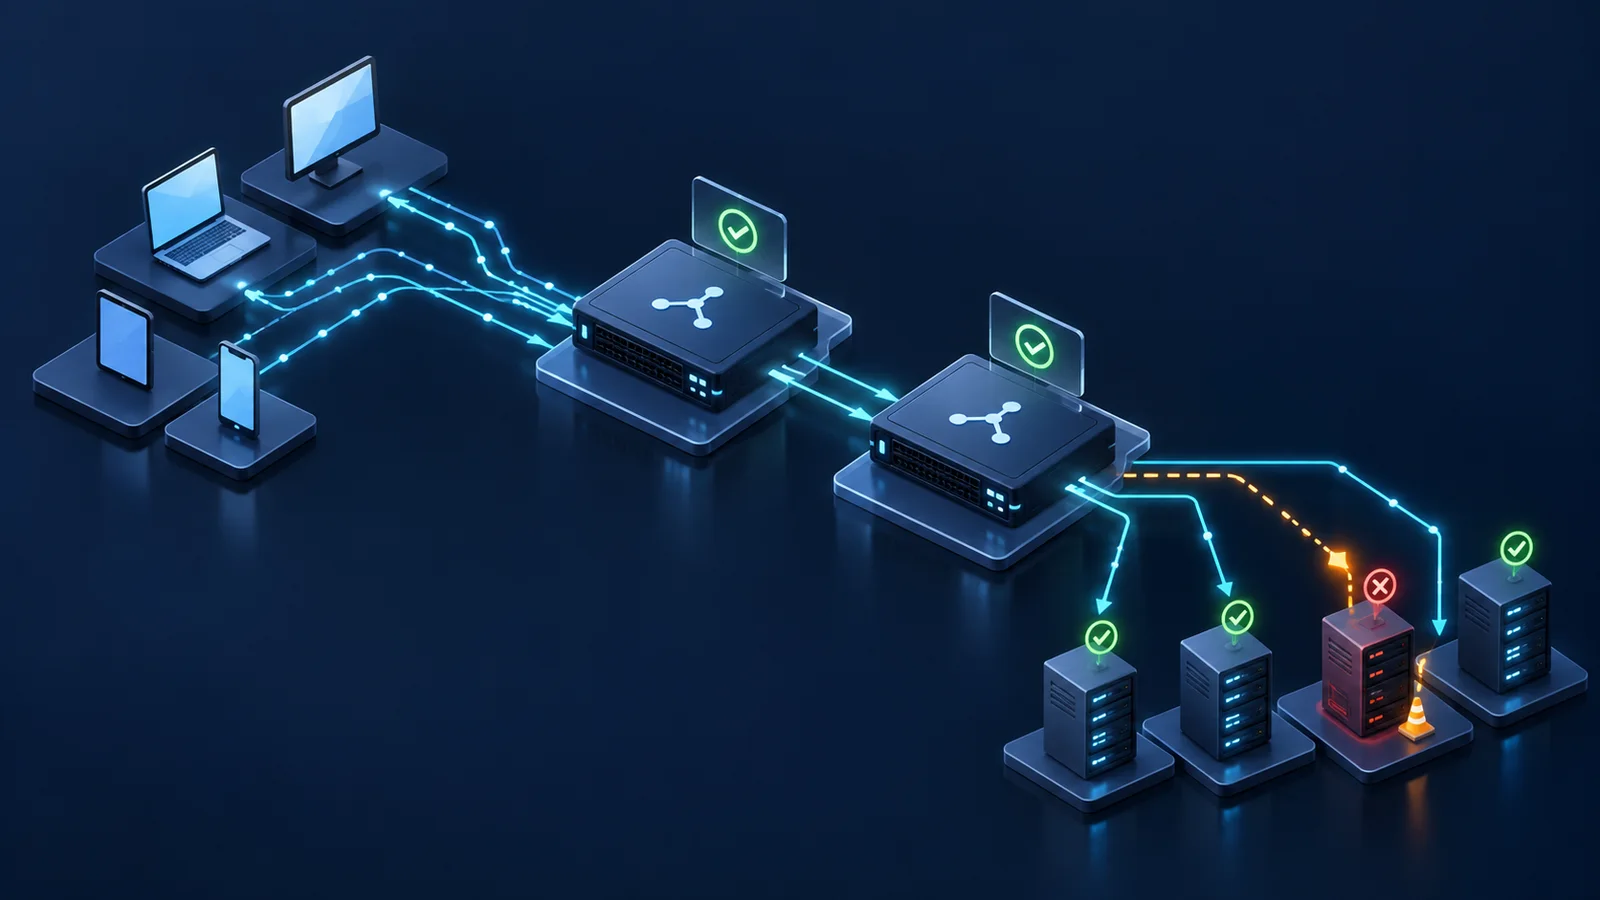
Mục lục bài viết 10 phần
Load balancer có thể đánh dấu backend “healthy” trong khi ứng dụng đã chậm, phụ thuộc downstream bị lỗi hoặc chỉ một API quan trọng hỏng. Ngược lại, health check quá nhạy có thể loại hàng loạt backend trong microburst. Test plan phải nối health signal với request success, connection/session, retry, draining và thời gian phục hồi ở cả L4 lẫn L7.
Bài viết giúp bạn
- Câu hỏi kỹ thuật cần trả lời
- Topology và traffic profile
- Biến số phải kiểm soát
Câu hỏi kỹ thuật cần trả lời
#Bài kiểm thử cần xác định load balancer phát hiện backend lỗi trong bao lâu, dừng gửi request mới khi nào, xử lý connection đang mở ra sao, retry có tạo duplicate hoặc thundering herd không, và node/zone failover có giữ virtual IP, session và route đúng không.
Health check pass không chứng minh transaction end-to-end. Cần ít nhất ba lớp: transport health, application readiness và synthetic business transaction. Mỗi lớp có cost và phạm vi khác nhau; dùng một URL luôn trả 200 có thể che lỗi database hoặc dependency.
Topology và traffic profile
#Topology tối thiểu gồm client/load generator ở hai mạng, cặp hoặc service load balancer, 3–5 backend, dependency mô phỏng, DNS nếu dùng, network emulator và điểm capture hai phía. Nếu triển khai cloud managed, ghi region/zone, SKU/tier, policy và control-plane dependency.
Traffic gồm request ngắn idempotent, POST có transaction ID, upload/download lớn, keep-alive, HTTP/2 multiplexing, WebSocket hoặc gRPC/stream nếu dùng production. Tách new connection rate với concurrent connection; thêm traffic nền để tạo CPU, queue và dependency slowdown.
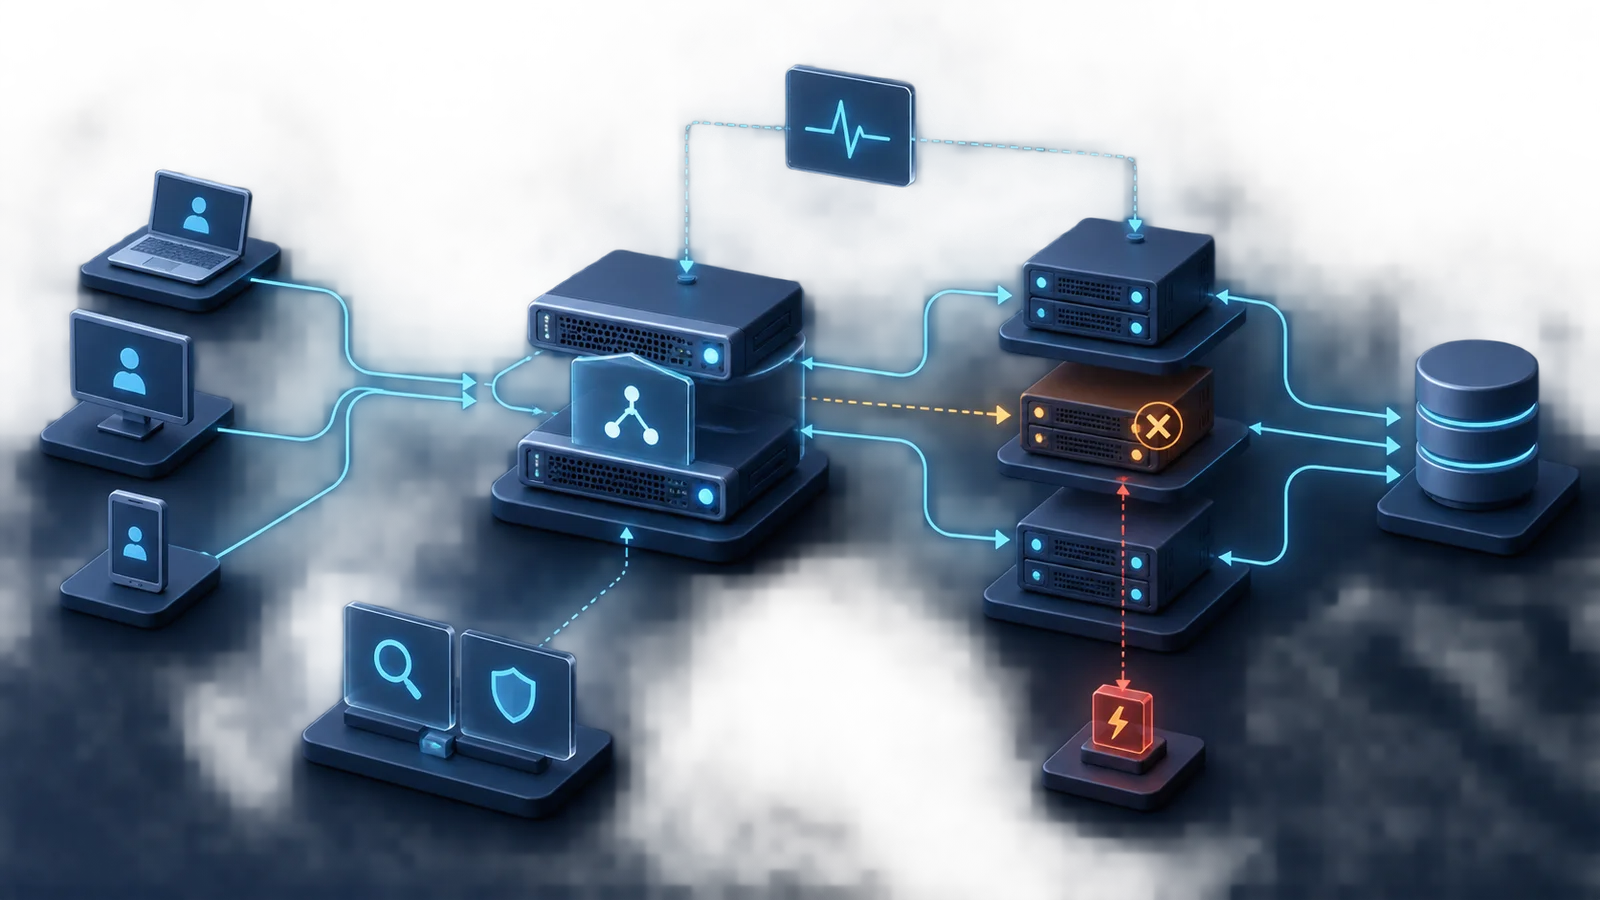
Biến số phải kiểm soát
#Khóa health interval, timeout, healthy/unhealthy threshold, probe source, protocol, expected code/body, backend weight, algorithm, persistence, idle timeout, draining timeout, retry policy và connection reuse. Ghi TLS termination/passthrough, certificate, SNI/Host và HTTP version.
Đồng bộ clock và gắn request ID end-to-end. Nếu dùng autoscaling, tắt hoặc kiểm soát trong baseline; sau đó test riêng. Không đổi health threshold và traffic cùng lúc. Ghi backend capacity và dependency latency vì queue có thể là nguyên nhân thật.
- Biến số: Probe · Cần ghi: interval/timeout/threshold/path · Tác động: Detection và false positive
- Biến số: Distribution · Cần ghi: round-robin/least/consistent hash · Tác động: Fairness và remap
- Biến số: Persistence · Cần ghi: cookie/source/none · Tác động: Session và hotspot
- Biến số: Timeout · Cần ghi: connect/idle/request/drain · Tác động: Reset, retry, long flow
- Biến số: Retry · Cần ghi: layer, count, budget · Tác động: Duplicate/amplification
- Biến số: TLS/HTTP · Cần ghi: terminate/pass, H1/H2/H3 · Tác động: Connection semantics
KPI và bằng chứng đầu ra
#Đo request success/error theo loại, latency p50/p95/p99, detection time, backend removal time, service restoration, connection reset, duplicate transaction, retry count, backend distribution/fairness, new connection rate và active connections. Với failover, đo VIP reachability, route/ARP/ND update và session survival.
Bằng chứng gồm client result có request ID, access/error log load balancer, backend log, pool state timeline, health-probe log, packet capture, route/neighbor state và dependency metric. Một dashboard “healthy targets” không đủ nếu client vẫn nhận 502/503 hoặc timeout.
Ma trận lỗi và quyết định
#- Ca: LB-01 · Lỗi/sự kiện: Baseline · Kỳ vọng: Phân phối đúng, không lỗi · Pass/fail chính: p99 và fairness trong ngưỡng
- Ca: LB-02 · Lỗi/sự kiện: Backend process stop · Kỳ vọng: Probe loại target · Pass/fail chính: Detection/restoration trong SLA
- Ca: LB-03 · Lỗi/sự kiện: App trả 200 nhưng dependency lỗi · Kỳ vọng: Business health phát hiện · Pass/fail chính: Không tiếp tục gửi traffic lỗi
- Ca: LB-04 · Lỗi/sự kiện: Backend chậm · Kỳ vọng: Không gây queue/retry storm · Pass/fail chính: Error/latency và retry budget
- Ca: LB-05 · Lỗi/sự kiện: Drain backend · Kỳ vọng: Không nhận kết nối mới ở L4 hoặc request mới ở L7 theo khả năng sản phẩm; flow cũ theo policy · Pass/fail chính: Không reset ngoài ngưỡng
- Ca: LB-06 · Lỗi/sự kiện: Node LB fail · Kỳ vọng: VIP/route chuyển · Pass/fail chính: Loss và restoration trong SLA
- Ca: LB-07 · Lỗi/sự kiện: Persistence hotspot · Kỳ vọng: Phân bố được quan sát/cảnh báo · Pass/fail chính: Không overload im lặng
- Ca: LB-08 · Lỗi/sự kiện: Khôi phục target · Kỳ vọng: Warm-up/ramp an toàn · Pass/fail chính: Không flap hoặc surge
Test plan health check và slow failure
#Đầu tiên dừng process/backend port để đo fault rõ. Sau đó tạo lỗi khó hơn: thread pool cạn, latency dependency tăng, partial API failure, disk read-only, response sai body hoặc TLS certificate lỗi. So transport probe, HTTP readiness và synthetic transaction để biết lớp nào phát hiện.
Tạo microburst và packet loss ngắn trên probe path nhưng không trên data path, rồi ngược lại. Mục tiêu là phát hiện false eviction và blind spot. Kiểm hysteresis: backend không flap khi latency quanh threshold; khi phục hồi, warm-up tránh nhận full load ngay nếu ứng dụng cần cache/JIT.
Không nên loại toàn bộ backend chỉ vì một dependency dùng chung tạm lỗi nếu điều đó làm outage lan rộng. Tách cảnh báo business health khỏi quyết định eviction, kiểm failure threshold, quorum/capacity và cơ chế all-targets-unhealthy của đúng sản phẩm.
Test plan draining, persistence và long-lived connection
#Mở nhiều keep-alive, HTTP/2 stream và long-lived connection, sau đó đặt backend vào drain. Phân biệt L4 ngừng phân phối kết nối mới với L7 ngừng gửi request mới. Request/stream mới trên kết nối đang tồn tại có thể vẫn tới backend nếu sản phẩm không có cơ chế quiesce tương ứng; kiểm GOAWAY/graceful shutdown và policy của từng protocol. Đo khi draining timeout hết: graceful close hay reset; client retry có giữ idempotency không.
Với persistence, tạo session phân bố theo nhiều source/cookie, down backend và quan sát remap. Kiểm cookie hết hạn/sai chữ ký, NAT tập trung nhiều client và consistent hash churn. Persistence không được che backend lỗi hoặc làm một target overload kéo dài.
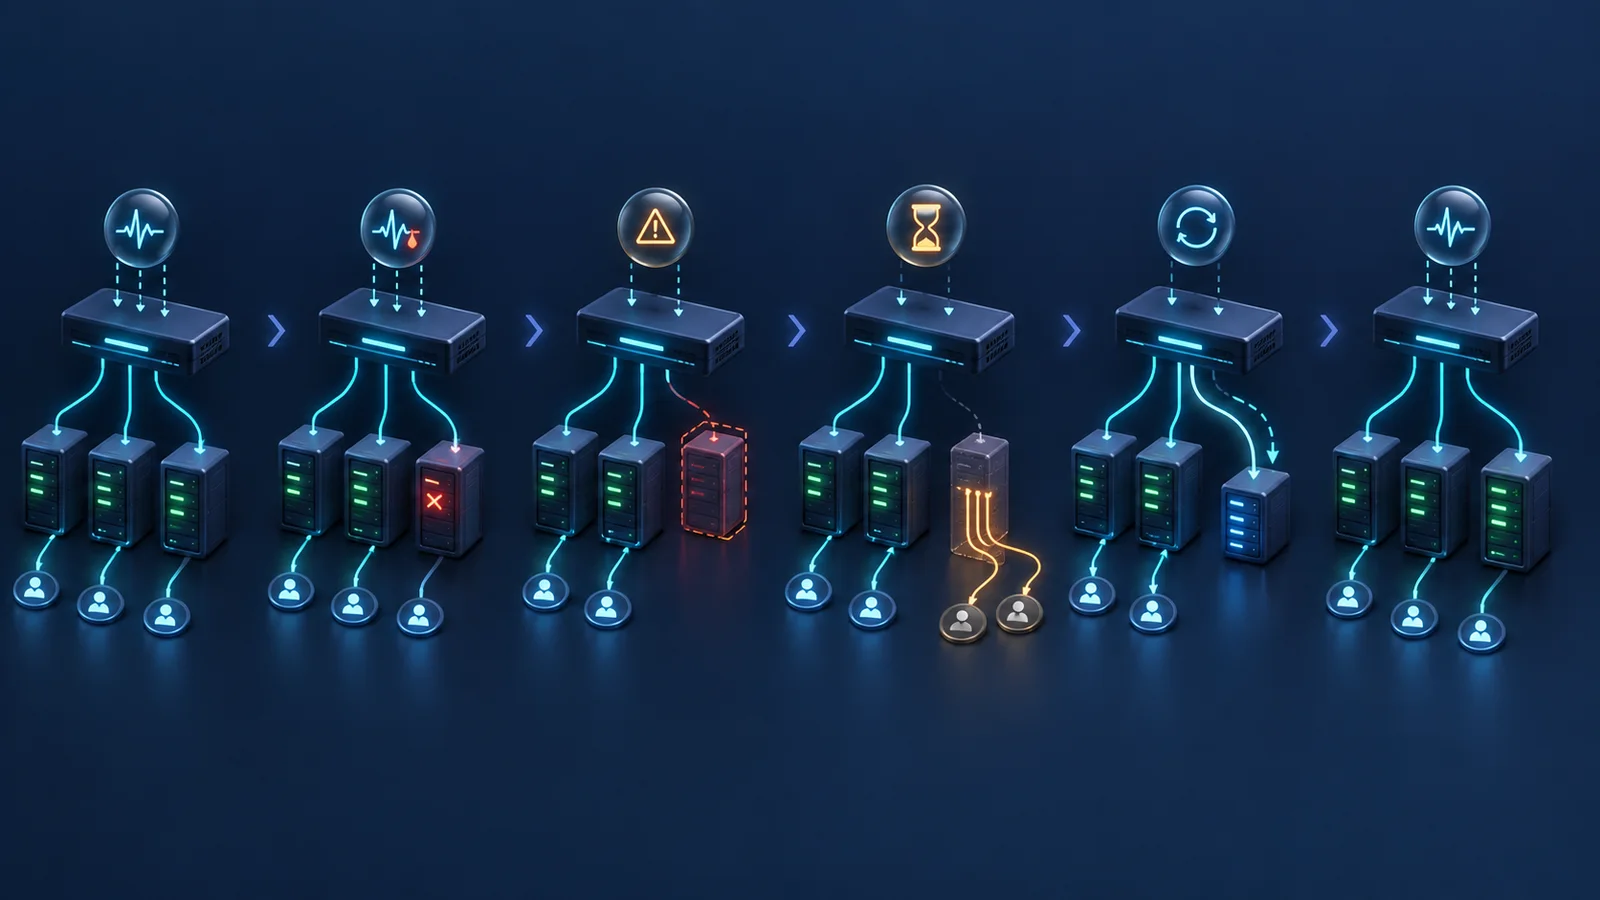
Test plan node failover và runbook
#Tách control-plane failover với data-plane restoration. Một node trở thành active không đồng nghĩa session đã phục hồi. Với POST/non-idempotent, kiểm duplicate bằng transaction ID; không bật retry tùy tiện chỉ để giảm error rate.
- Chụp cấu hình VIP, pool, probe, routing, persistence và timeout.
- Chạy baseline từng protocol và traffic profile.
- Inject từng lỗi backend; đo detection, removal và client outcome.
- Thực hiện draining khi có short/long connection.
- Fail node/process/interface/zone load balancer theo phạm vi được phép.
- Thu ARP/ND, route, packet, pool state và request timeline.
- Khôi phục từng thành phần; quan sát warm-up, flap và state sync.
- Lặp đủ số lần, báo percentile/worst case và phân loại error.
Giới hạn kết luận
#Kết quả phụ thuộc implementation, tier, protocol, persistence, backend và traffic mix. Managed load balancer có control plane không quan sát được hoàn toàn; cần kết luận theo evidence khả dụng và ghi giới hạn. Test một AZ không chứng minh regional disaster recovery.
Health check và failover tốt không thay thế capacity planning. Không suy performance từ tải thấp sang reconnect storm hoặc peak. Mọi con số phải gắn với version, topology, connection profile và failure method.
Khái niệm cần nhớ
#- Liveness: Tiến trình còn sống.
- Readiness: Backend sẵn sàng nhận request mới.
- Connection draining: Ngừng phân phối mới nhưng cho flow hiện tại kết thúc theo policy.
- Persistence: Cơ chế giữ client/session về cùng backend.
- Retry amplification: Nhiều lớp retry làm tăng tải vượt request ban đầu.
- Service restoration: Thời gian dịch vụ trở lại tiêu chí pass, không chỉ control plane chuyển vai trò.
Khái niệm cần nhớ
- DUT / SUT
- Thiết bị hoặc toàn bộ hệ thống đang là đối tượng của bài kiểm thử.
- Steady state
- Giai đoạn tải đã ổn định và đủ điều kiện để lấy số liệu đại diện.
- Pass / fail
- Kết luận dựa trên ngưỡng đã thống nhất, luôn đi cùng topology, cấu hình và điều kiện đo.
TÀI LIỆU ĐỐI CHIẾUTài liệu tham khảo3 nguồn +
Nội dung được biên soạn độc lập, theo hướng vendor-neutral và đối chiếu các tài liệu gốc dưới đây. Tính năng sản phẩm cần được kiểm tra lại theo phiên bản đang sử dụng.
NetVali ưu tiên nguồn tiêu chuẩn và tài liệu chính thức; phân biệt khuyến nghị triển khai với yêu cầu của tiêu chuẩn; không công bố thông số sản phẩm chưa gắn với phiên bản và điều kiện đo.