
Mục lục bài viết 7 phần
Bài Google Cloud Blog hiện ghi ngày 10/09/2026 công bố rằng AlloyDB Omni Red Hat RPM Orchestrator đã General Availability, phát hành cùng AlloyDB Omni 18.3.0. Với hệ thống tự quản lý trên VM hoặc bare metal, giá trị thực tế không nằm ở nhãn GA mà ở khả năng chứng minh failover, read routing, backup/PITR, maintenance và rollback trong topology cụ thể.
Bài viết giúp bạn
- Thông tin được công bố
- Điểm mới đáng chú ý
- Tác động đối với kiến trúc/vận hành/kiểm thử
Thông tin được công bố
#Bài blog Google hiện ghi ngày 10/09/2026 thông báo RPM Orchestrator đã GA và ra mắt cùng AlloyDB Omni 18.3.0. Ngày này là ngày hiển thị của bài blog được đối chiếu, không dùng thay cho ngày phát hành từng package trong release notes. Hãng liệt kê bốn deployment mode: standalone container Debian/UBI; container với Kubernetes operator cho HA; standalone RPM; và RPM Orchestrator cho HA trên hạ tầng doanh nghiệp.
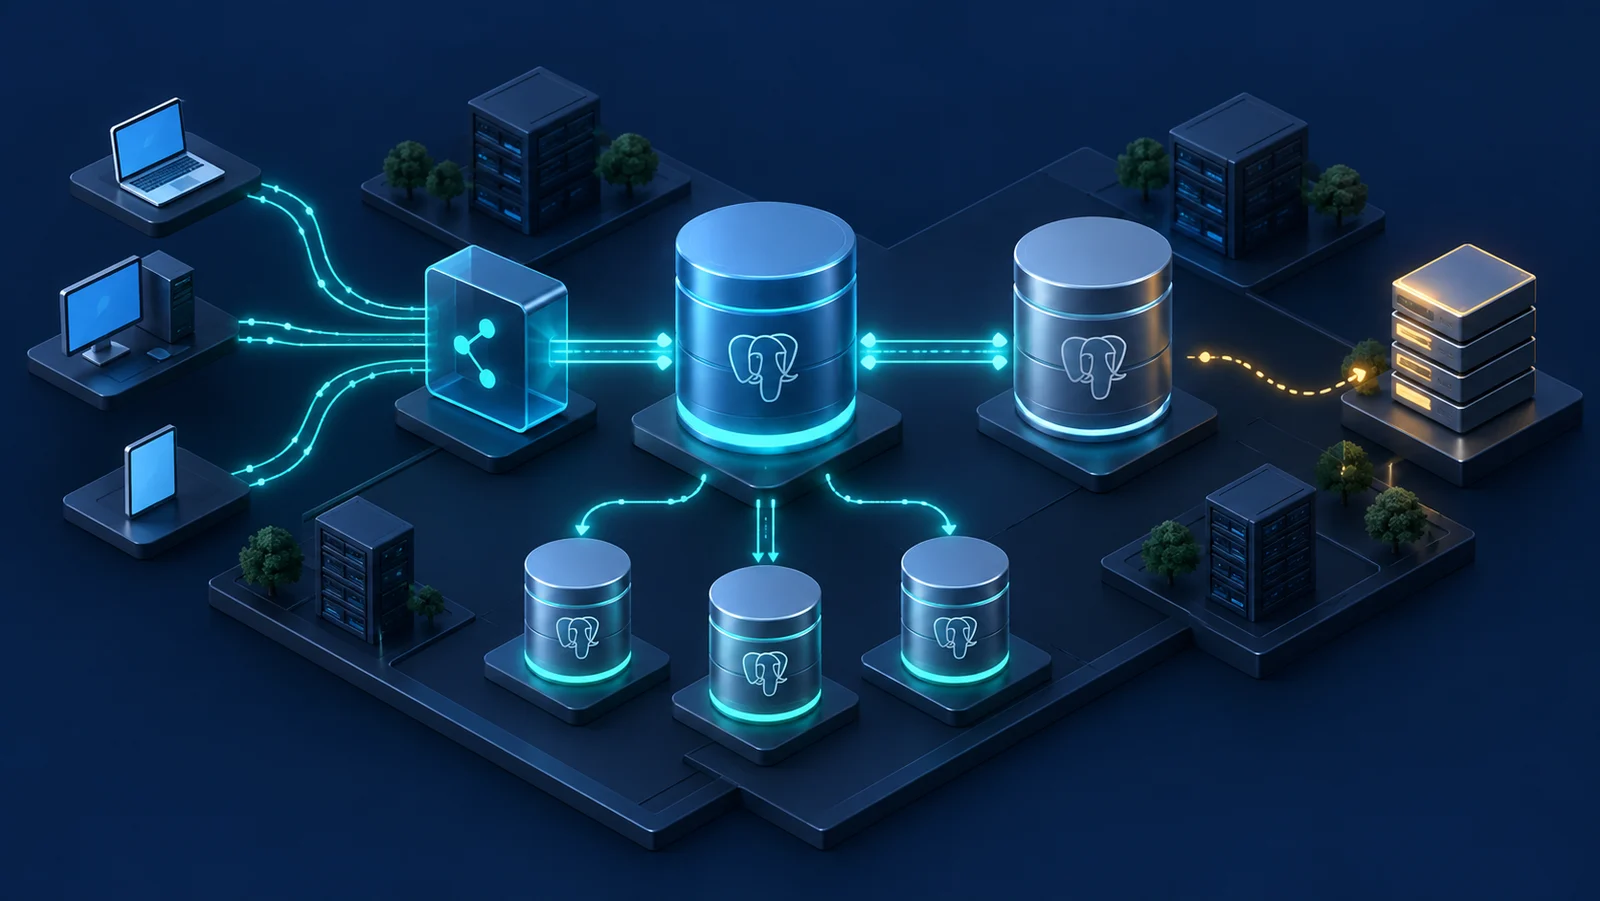
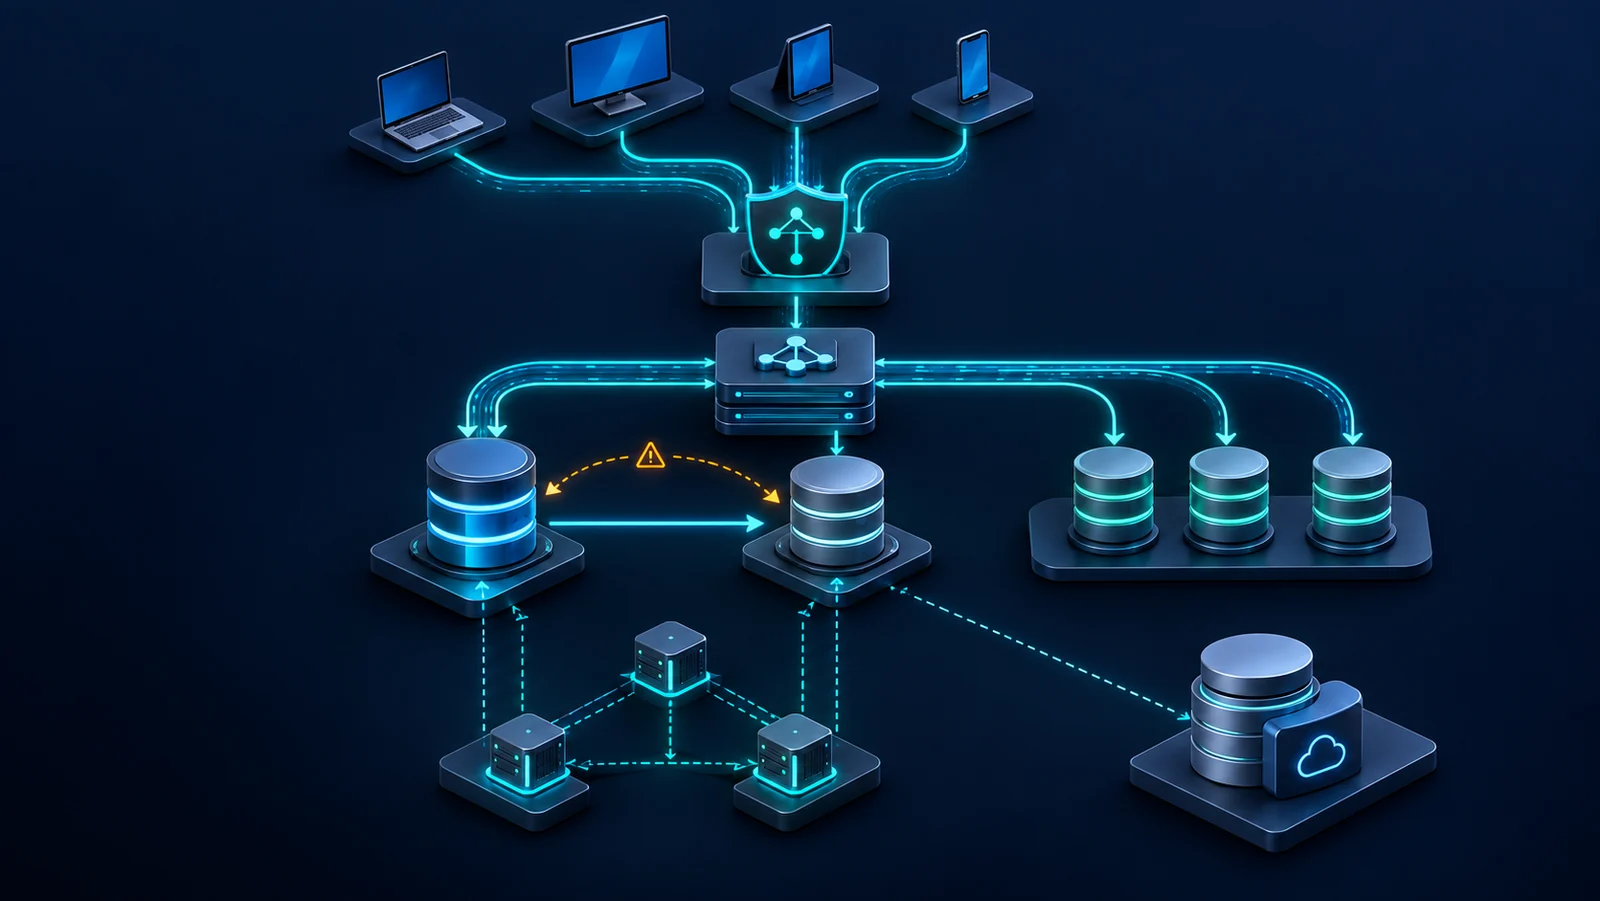
Reference architecture được công bố gồm active primary với synchronous replication cho HA, read pool nhận asynchronous replication, VIP/Keepalived, PgBouncer, HAProxy, các cluster manager dự phòng và distributed configuration store etcd ba node. Đây là kiến trúc tham chiếu; số node, placement và failure domain production vẫn phải được xác minh trong tài liệu và cấu hình triển khai.
Điểm mới đáng chú ý
#Google mô tả read pool có endpoint riêng; backup/restore tự động tới Google Cloud Storage, S3-compatible storage hoặc local; point-in-time recovery và in-place PIT restore; SELinux enforcement; dynamic configuration; add/remove node; custom metrics; và Low Downtime Maintenance cho minor-version upgrade hoặc thay đổi CPU/memory có automatic rollback.
Google cũng nêu AlloyDB Omni có thể nhanh hơn 2 lần cho transactional workload và tới 100 lần cho analytical query so với standard PostgreSQL. Đây là tuyên bố hiệu năng của Google, không phải benchmark độc lập và không nên dùng làm acceptance threshold nếu thiếu dataset, query, hardware, cache state, concurrency và phép đo tương ứng.
- Nội dung: RPM Orchestrator GA · Trạng thái công bố: Google, 10/09/2026 · Bằng chứng cần thêm: Support matrix và exact package 18.3.0
- Nội dung: HA primary/standby · Trạng thái công bố: Reference architecture · Bằng chứng cần thêm: Failover từng failure domain
- Nội dung: Read pool async · Trạng thái công bố: Google · Bằng chứng cần thêm: Replica lag, stale-read tolerance
- Nội dung: Backup/PITR · Trạng thái công bố: Google · Bằng chứng cần thêm: Restore hoàn tất và data consistency
- Nội dung: Low-downtime maintenance · Trạng thái công bố: Google · Bằng chứng cần thêm: Downtime, rollback và transaction outcome
- Nội dung: 2X/100X performance · Trạng thái công bố: Tuyên bố Google · Bằng chứng cần thêm: Benchmark độc lập theo workload
Tác động đối với kiến trúc/vận hành/kiểm thử
#On-premises orchestration thêm control plane, node manager, etcd, load-balancing tier và storage/network dependency. Mỗi lớp có failure mode riêng. VIP chuyển nhưng PgBouncer giữ connection cũ, hoặc primary failover thành công nhưng application pool không reconnect, đều có thể làm service restoration dài hơn database role transition.
Test plan phải đo transaction outcome, connection error, RPO/RTO, replica lag, stale read, backup age, restore consistency và maintenance downtime. Với synchronous replication qua zone, chèn latency/jitter/loss để tìm operating envelope; với read pool async, định nghĩa rõ mức stale được phép thay vì gọi mọi query read-only là thành công.
Ai cần quan tâm
#Nhóm mua sắm hoặc kiến trúc không nên coi GA là bằng chứng phù hợp mọi hardware/OS. Cần chốt support matrix, entitlement, upgrade path và boundary trách nhiệm giữa Google, hệ điều hành, storage và đội on-premises.
- DBA và platform team vận hành PostgreSQL-compatible workload ngoài managed cloud.
- Tổ chức cần data residency, bare metal, edge hoặc môi trường không container.
- SRE chịu trách nhiệm HA, observability, backup và maintenance.
- Security/compliance team đánh giá SELinux, audit log và key/credential boundary.
- Application owner cần xác minh driver, pool, retry và read consistency.
Những điểm chưa thể kết luận
#Công bố không chứng minh RPO bằng zero, failover không mất transaction, hoặc maintenance không gián đoạn trong mọi topology. Cụm từ low downtime không phải zero downtime. Automatic rollback cũng cần kiểm điều kiện kích hoạt và trạng thái transaction/config nếu upgrade thất bại giữa chừng.
NetVali chưa độc lập xác minh các mức 2X/100X, mọi extension, SELinux policy, S3-compatible target hoặc cross-zone behavior. Google nói các khả năng business continuity và cross-region resiliency nâng cao còn là hướng mở rộng sắp tới; không nên diễn đạt chúng như tính năng GA hiện tại.
Checklist hành động hoặc kiểm chứng
#- Bước 1: Xác nhận package, AlloyDB Omni 18.3.0, Red Hat release, hardware và support matrix.
- Bước 2: Vẽ failure-domain map cho power, host, rack/zone, network, storage và control plane.
- Bước 3: Chạy baseline query/transaction với dataset, concurrency và cache state được lưu.
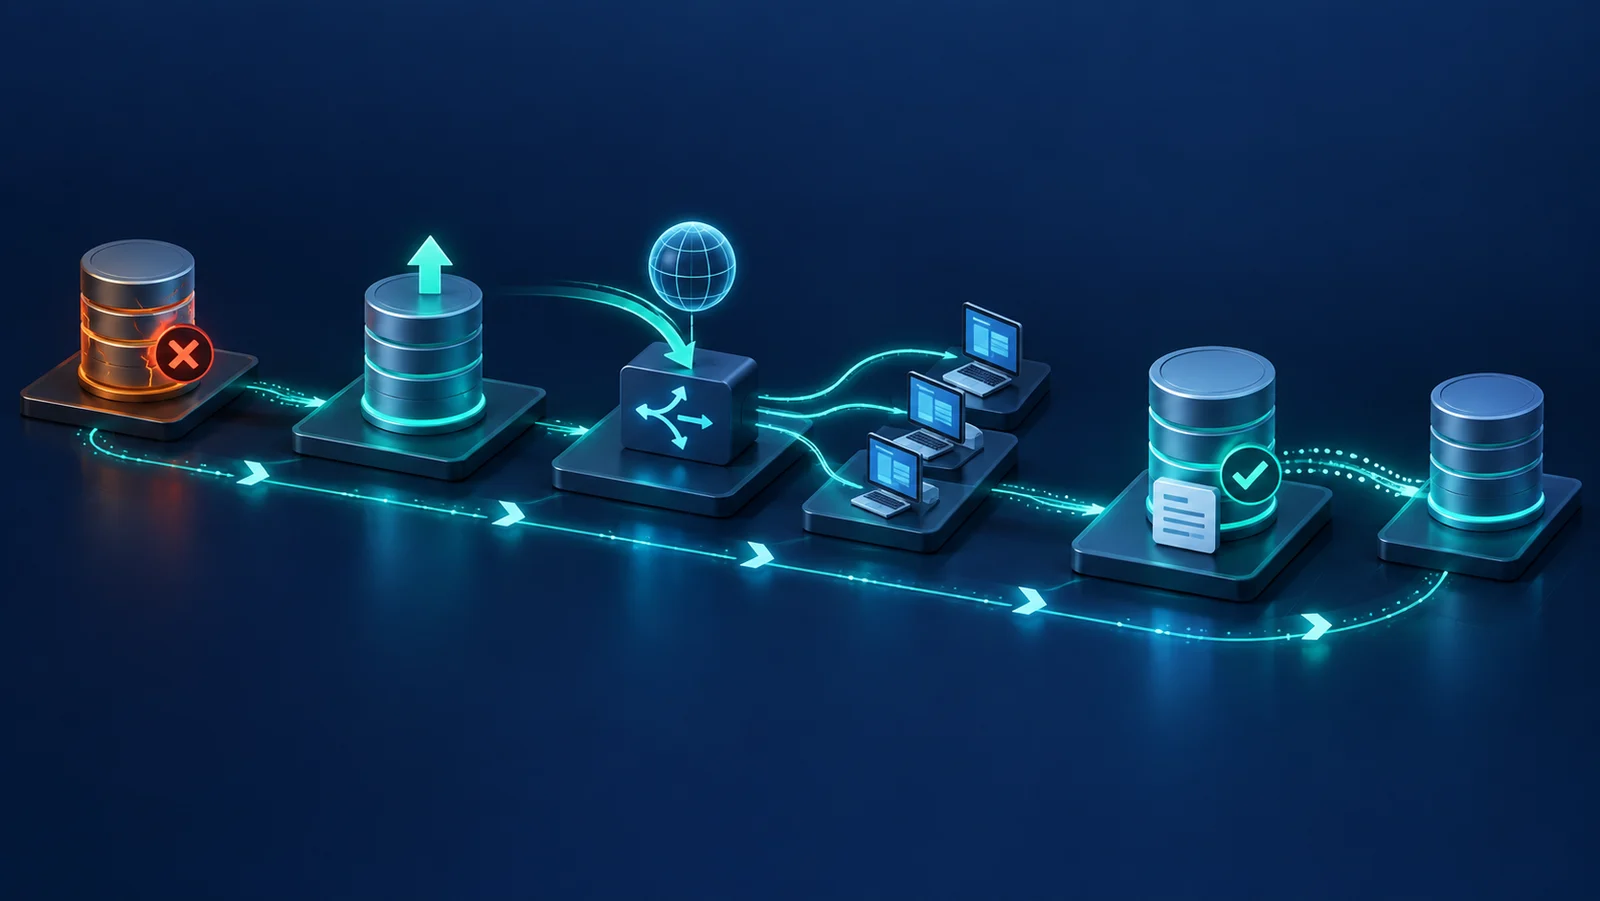
- Bước 4: Fail primary, standby, VIP node, PgBouncer/HAProxy, cluster manager và một etcd node riêng biệt.
- Bước 5: Đo role transition, connection recovery, transaction loss/duplicate và RTO/RPO.
- Bước 6: Tạo network impairment giữa database nodes; đo commit latency và stability.
- Bước 7: Tạo read pool lag; xác minh routing, stale-read threshold và read-after-write behavior.
- Bước 8: Backup tới từng target nằm trong phạm vi; restore và kiểm checksum/transaction consistency.
- Bước 9: Thử PITR quanh transaction marker; đo restore time và data boundary.
- Bước 10: Chạy minor upgrade/resource change; đo downtime và cố ý kích rollback trong lab.
- Bước 11: Xuất log/metrics/audit, kiểm SELinux mode và alert coverage.
- Bước 12: Chỉ phê duyệt khi report ghi topology, version, workload và giới hạn kết luận.
Khái niệm cần nhớ
#- GA: trạng thái phát hành chung; không thay thế acceptance test.
- Synchronous replication: commit phụ thuộc xác nhận theo cơ chế đồng bộ đã cấu hình.
- Read pool: replica phục vụ đọc, có thể có lag vì replication bất đồng bộ.
- VIP: địa chỉ ảo dùng để chuyển endpoint giữa các node.
- PITR: khôi phục dữ liệu tới một thời điểm mục tiêu.
- RPO/RTO: lượng dữ liệu có thể mất và thời gian phục hồi chấp nhận được.
Khái niệm cần nhớ
- DUT / SUT
- Thiết bị hoặc toàn bộ hệ thống đang là đối tượng của bài kiểm thử.
- Steady state
- Giai đoạn tải đã ổn định và đủ điều kiện để lấy số liệu đại diện.
- Pass / fail
- Kết luận dựa trên ngưỡng đã thống nhất, luôn đi cùng topology, cấu hình và điều kiện đo.
TÀI LIỆU ĐỐI CHIẾUTài liệu tham khảo4 nguồn +
Nội dung được biên soạn độc lập, theo hướng vendor-neutral và đối chiếu các tài liệu gốc dưới đây. Tính năng sản phẩm cần được kiểm tra lại theo phiên bản đang sử dụng.
NetVali ưu tiên nguồn tiêu chuẩn và tài liệu chính thức; phân biệt khuyến nghị triển khai với yêu cầu của tiêu chuẩn; không công bố thông số sản phẩm chưa gắn với phiên bản và điều kiện đo.