
Mục lục bài viết 10 phần
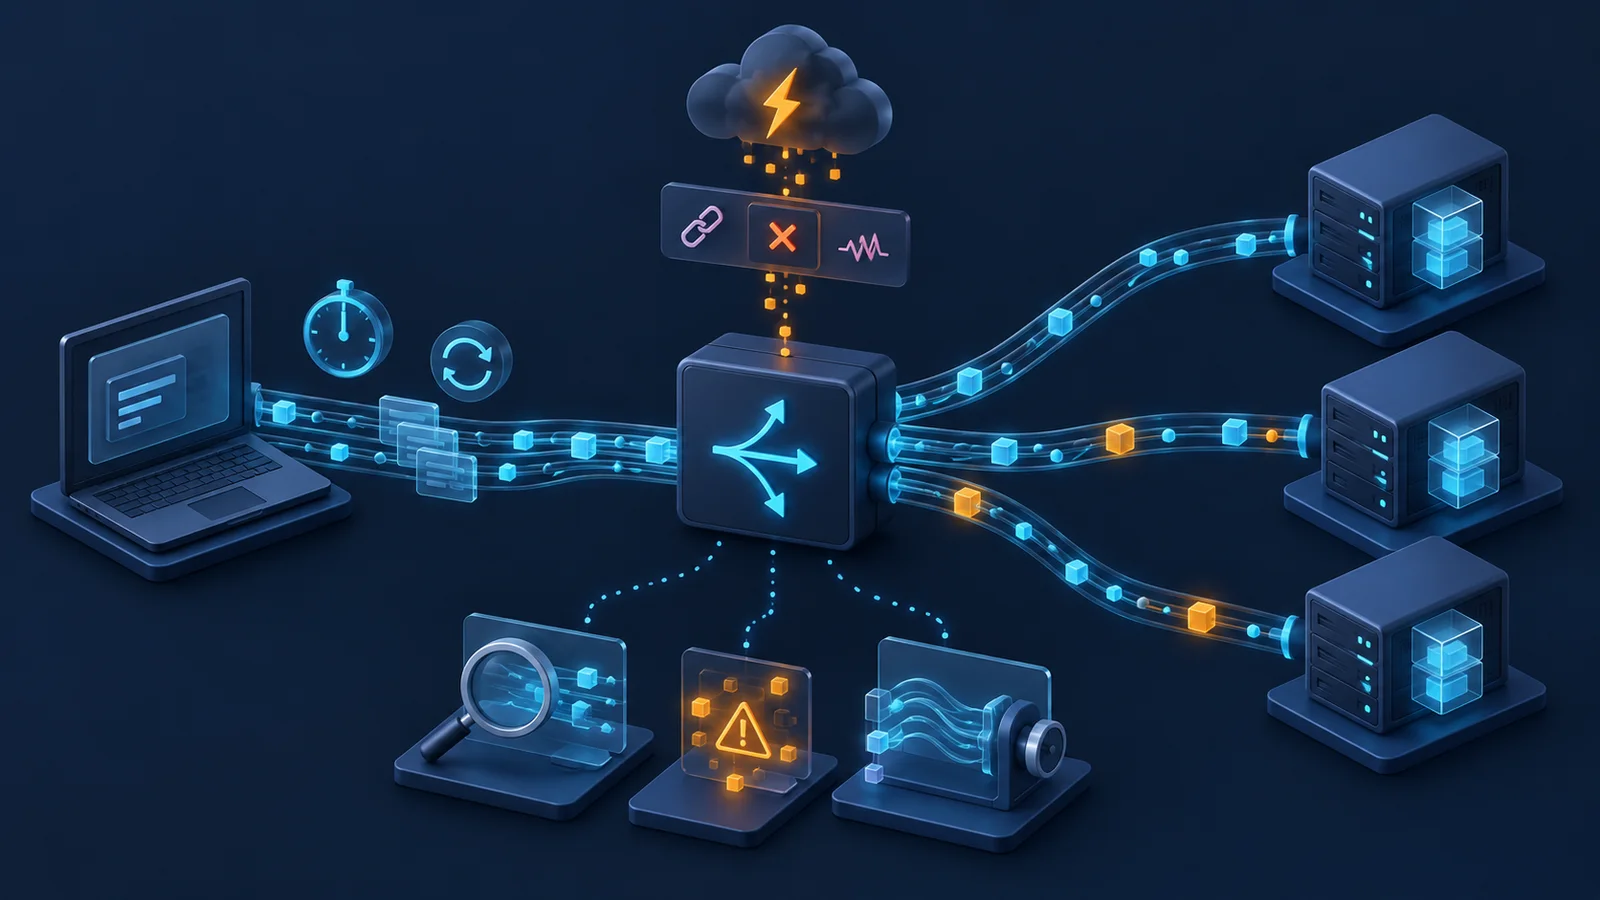
gRPC có thể trả lời nhanh ở tải thấp nhưng suy giảm đột ngột khi deadline ngắn, retry đồng loạt hoặc consumer đọc chậm. Bài đo tốt phải tách call logic khỏi từng attempt, đồng thời quan sát queue, flow control và tác động lên backend.
Bài viết giúp bạn
- Câu hỏi cần trả lời trước khi tạo tải
- Topology và điểm đo
- Traffic profile và biến phải kiểm soát
Câu hỏi cần trả lời trước khi tạo tải
#Không nên bắt đầu bằng “gRPC đạt bao nhiêu request/giây”. Trước hết phải xác định loại RPC, kích thước message, tỷ lệ đọc/ghi, idempotency, deadline theo nghiệp vụ và trạng thái nào được phép retry. Một unary lookup khác hoàn toàn stream telemetry tồn tại hàng giờ.
Tách ba câu hỏi: năng lực ở steady state; hành vi khi một dependency chậm hoặc lỗi; và khả năng trở về baseline sau sự cố. Nếu chỉ đo pha đầu, kết quả chưa chứng minh được độ bền vận hành.
Topology và điểm đo
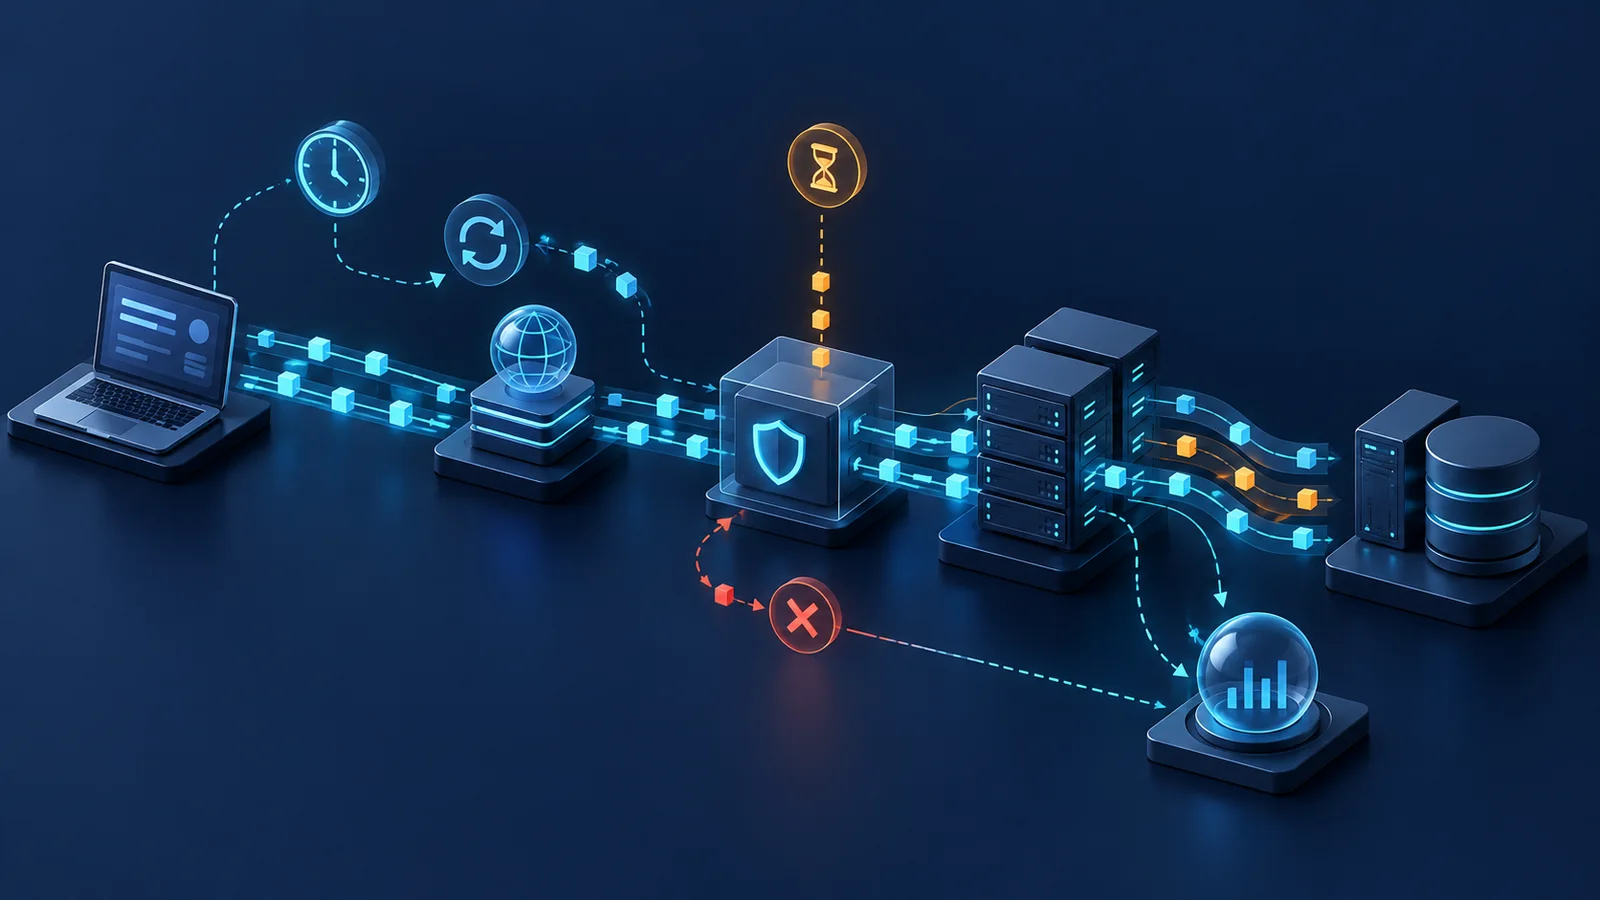
#Topology tối thiểu gồm load generator gRPC, DNS/service discovery, load balancer hoặc service mesh nếu có, ít nhất hai backend, dependency mô phỏng và bộ chèn latency/loss/reset. Đồng bộ clock giữa các điểm thu thập để ghép client span, proxy log và server metric.
Đặt capture trước và sau proxy khi cần phân biệt lỗi transport với quyết định ở application. Với TLS, ưu tiên trace/metric có correlation ID; packet capture không giải mã chỉ cho thấy thông tin transport/TLS quan sát được và timing; không đọc được HTTP/2 frame hoặc gRPC message nằm trong TLS.
Traffic profile và biến phải kiểm soát
#Giữ riêng unary, server streaming, client streaming và bidirectional streaming. Với mỗi profile, ghi rõ số channel, concurrent stream, request rate, message size distribution, compression, connection lifetime, metadata, TLS mode và thời gian warm-up. Một channel có nhiều stream không tương đương nhiều connection.
Không dùng payload rỗng nếu production có serialize, copy và compression đáng kể. Phân phối kích thước và think time nên lấy từ baseline thật rồi thêm worst credible case. Cố định phiên bản client library, server runtime, proxy và service config vì retry/keepalive/load balancing có thể khác theo implementation.
- Biến: RPC type · Baseline cần lưu: Tỷ lệ từng method · Bài thử biên: Tách riêng từng kiểu streaming
- Biến: Deadline · Baseline cần lưu: Theo method · Bài thử biên: Ngắn hơn p99 và dài hơn ngưỡng overload
- Biến: Message · Baseline cần lưu: p50/p95/max · Bài thử biên: Burst message lớn
- Biến: Concurrency · Baseline cần lưu: Số call và stream · Bài thử biên: Ramp, spike, soak
- Biến: Network · Baseline cần lưu: RTT/loss bình thường · Bài thử biên: Delay, loss, reset có kiểm soát
- Biến: Backend · Baseline cần lưu: CPU, queue, pool · Bài thử biên: Một node chậm, mất node, dependency timeout
Deadline, cancellation và retry
#Tài liệu gRPC khuyến nghị client đặt deadline thực tế; mặc định không có deadline có thể khiến call chờ rất lâu. Khi deadline hết, client thấy DEADLINE_EXCEEDED; server vẫn phải dừng công việc con khi nhận cancellation. Vì vậy bài thử phải kiểm cả status ở client lẫn tài nguyên server có được giải phóng hay không.
Retry tạo attempt mới và có thể khuếch đại tải đúng lúc backend yếu nhất. Ghi đồng thời logical calls, total attempts, retryable status, backoff, server pushback và số thao tác nghiệp vụ thực sự được commit. Với method không idempotent, không bật retry chỉ để cải thiện success rate.
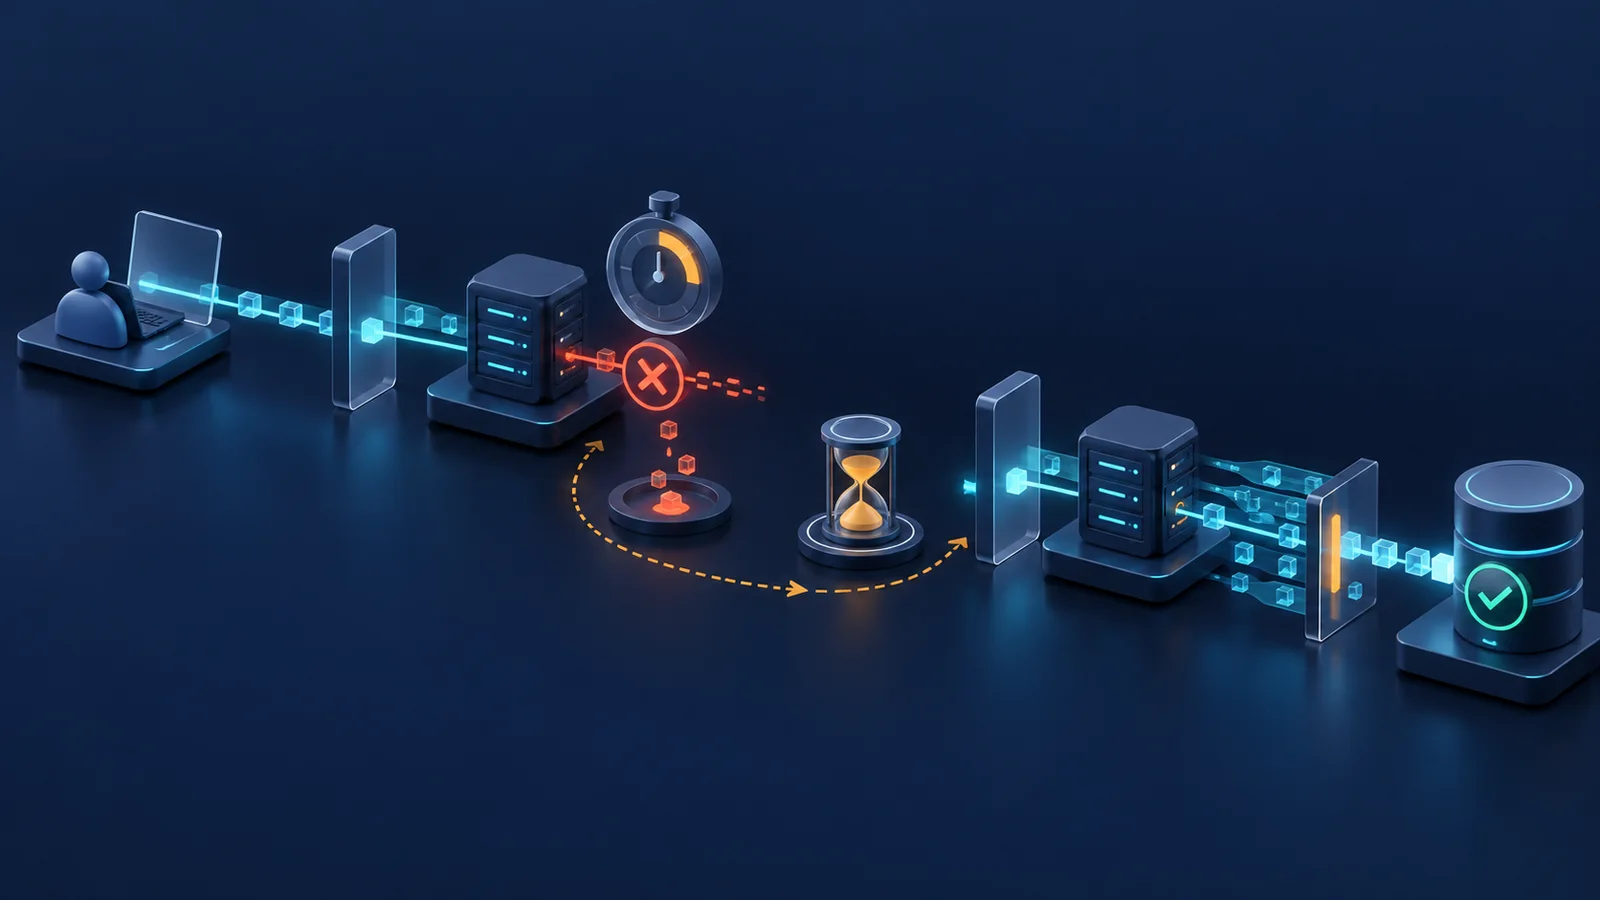
Một ca quan trọng: cho attempt đầu lỗi bằng status được phép retry khi deadline tổng còn hiệu lực; chạy riêng ca deadline tổng hết hạn rồi phục hồi dependency. Pass khi call kết thúc đúng policy, không double-write, cancellation dọn tài nguyên và retry traffic không làm hệ thống chuyển từ suy giảm cục bộ thành overload toàn cụm.
Deadline áp dụng cho toàn bộ RPC, gồm cả thời gian backoff và các attempt. Khi deadline tổng hết hạn, cùng RPC không được tiếp tục retry; một lần gọi mới do ứng dụng tạo là logical call khác. Retry cũng bị giới hạn bởi trạng thái commit của RPC và hỗ trợ của thư viện.
Streaming, flow control và backpressure
#gRPC flow control bảo vệ receiver khỏi sender quá nhanh và chủ yếu liên quan streaming RPC. Write trả về không nhất thiết đồng nghĩa dữ liệu đã ra mạng. Hãy mô phỏng consumer đọc chậm, tạm dừng đọc rồi đọc lại; đo buffer, memory, blocked write, message age và thời gian phục hồi.
Với manual flow control, cần kiểm nguy cơ hai phía cùng ghi nhiều nhưng không đọc, dẫn tới deadlock. Tạo profile burst theo message count và byte, không chỉ message/giây. Một stream lớn có thể chiếm queue trong khi unary traffic vẫn cần SLO riêng.
KPI và bằng chứng đầu ra
#Theo dõi success rate theo status code nhưng không dừng ở đó. Cần p50/p95/p99/p99.9 call latency, attempt latency, deadline exceeded, cancellation propagation, retry ratio, retry success, duplicate side effect, active stream, message throughput và memory/queue.
Định nghĩa pass/fail theo cửa sổ thời gian. “p99 dưới ngưỡng” phải nói rõ cửa sổ, tải, percentile population và có tính retry hay không. Lưu raw result, configuration hash, image/runtime version và fault timeline.
- Nhóm: Call · KPI: RPS, status, percentile latency · Bằng chứng: Client result và trace
- Nhóm: Retry · KPI: Attempts/call, backoff, throttle · Bằng chứng: OpenTelemetry metric, service config
- Nhóm: Streaming · KPI: Message age, blocked write, active stream · Bằng chứng: App metric, heap, transport trace
- Nhóm: Backend · KPI: CPU, queue, pool, commit count · Bằng chứng: Server metric và audit log
- Nhóm: Recovery · KPI: Time về baseline, error budget tiêu thụ · Bằng chứng: Time series trước–trong–sau fault
Ma trận quyết định
#Nếu mục tiêu là capacity, tắt fault và giữ policy ổn định. Nếu mục tiêu là resilience, giới hạn offered load ban đầu để phân biệt lỗi policy với thiếu capacity. Không gộp hai mục tiêu vào một con số throughput.
- Tình huống: Backend chậm · Điều cần chứng minh: Deadline chặn queue kéo dài · Dấu hiệu fail: Call hết hạn nhưng job vẫn chạy
- Tình huống: Một node lỗi · Điều cần chứng minh: Resolver/LB rút node đúng thời gian · Dấu hiệu fail: Retry dồn vào node còn lại
- Tình huống: Retryable error burst · Điều cần chứng minh: Backoff và throttle giới hạn amplification · Dấu hiệu fail: Attempts/call tăng mất kiểm soát
- Tình huống: Consumer chậm · Điều cần chứng minh: Flow control giữ memory trong biên · Dấu hiệu fail: Buffer tăng liên tục hoặc OOM
- Tình huống: Rolling restart · Điều cần chứng minh: Stream/call phục hồi theo policy · Dấu hiệu fail: Reconnect storm, duplicate side effect
- Tình huống: Dependency hồi phục · Điều cần chứng minh: Hệ thống trở lại baseline · Dấu hiệu fail: Queue tồn đọng kéo dài sau fault
Test plan và runbook
#Mỗi fault phải có control run không fault và ít nhất ba lần lặp. Dùng random seed đã lưu cho impairment; thay một biến mỗi vòng trước khi chạy tổ hợp worst credible case.
- Chụp version, service config, resolver/LB policy, deadline và retry policy theo method.
- Chạy functional baseline cho từng RPC type; đối chiếu kết quả nghiệp vụ.
- Warm-up rồi ramp concurrency; tìm knee point từ tail latency và queue.
- Giữ tải dưới knee point, chèn latency/loss/reset và một backend chậm.
- Chạy consumer-slow và pause/resume cho từng loại stream.
- Thử rolling restart, dependency outage và recovery; đánh dấu timeline.
- Đối chiếu logical call với attempt và commit để tìm duplicate/mất dữ liệu.
- Chạy soak đủ dài để phát hiện connection, stream hoặc memory leak.
- Xuất raw result, trace, metric, log, topology và verdict từng KPI.
Giới hạn kết luận
#Kết quả chỉ có giá trị cho runtime, phiên bản library, proxy/mesh, service config, RPC mix, payload, topology và tài nguyên đã thử. gRPC giữa các ngôn ngữ có thể khác cách bật retry, deadline propagation hoặc manual flow control; phải xác minh đúng implementation.
Packet loss thấp trong lab không chứng minh trải nghiệm trên WAN động. Tỷ lệ success tăng sau retry cũng không chứng minh an toàn nếu latency, tải backend hoặc duplicate side effect tăng. Kết luận nên gắn với bằng chứng đa lớp và điều kiện đo công khai.
Khái niệm cần nhớ
#- Logical call: Lời gọi mà ứng dụng nhìn thấy, có thể gồm nhiều attempt.
- Attempt: Một lần truyền RPC cụ thể, kể cả retry.
- Deadline: Thời điểm tối đa client chấp nhận chờ kết quả.
- Cancellation: Tín hiệu dừng xử lý khi call không còn cần thiết.
- Backpressure: Cơ chế buộc sender giảm tốc khi receiver không theo kịp.
- Flow control: Điều tiết dữ liệu in-flight của stream/transport.
- Retry amplification: Tải phát sinh thêm do retry khi hệ thống đang lỗi.
- Tail latency: Độ trễ ở percentile cao như p99 hoặc p99.9.
Khái niệm cần nhớ
- DUT / SUT
- Thiết bị hoặc toàn bộ hệ thống đang là đối tượng của bài kiểm thử.
- Steady state
- Giai đoạn tải đã ổn định và đủ điều kiện để lấy số liệu đại diện.
- Pass / fail
- Kết luận dựa trên ngưỡng đã thống nhất, luôn đi cùng topology, cấu hình và điều kiện đo.
TÀI LIỆU ĐỐI CHIẾUTài liệu tham khảo5 nguồn +
Nội dung được biên soạn độc lập, theo hướng vendor-neutral và đối chiếu các tài liệu gốc dưới đây. Tính năng sản phẩm cần được kiểm tra lại theo phiên bản đang sử dụng.
NetVali ưu tiên nguồn tiêu chuẩn và tài liệu chính thức; phân biệt khuyến nghị triển khai với yêu cầu của tiêu chuẩn; không công bố thông số sản phẩm chưa gắn với phiên bản và điều kiện đo.