
Mục lục bài viết 7 phần
Ngày 16/09/2026, Google Cloud công bố góc nhìn từ Google Threat Intelligence về ba thay đổi cấu trúc: AI thay đổi cách phát triển phần mềm, mở rộng attack surface và tăng năng lực của tác nhân đe dọa. Giá trị thực tế không nằm ở khẩu hiệu “AI threat”, mà ở việc chuyển từng quan sát thành inventory, telemetry và kịch bản kiểm chứng.
Bài viết giúp bạn
- Thông tin được công bố
- Điểm mới đáng chú ý
- Tác động đối với kiến trúc, vận hành và kiểm thử
Thông tin được công bố
#Google Cloud đăng bài ngày 16/09/2026, dẫn quan sát của Google Threat Intelligence Group. Nguồn chia rủi ro thành ba nhóm: tốc độ và cách AI tham gia software development; bề mặt tấn công mới quanh agent, model, tool và cloud identity; khả năng AI hỗ trợ hoạt động của tác nhân đe dọa.
Google nêu các ví dụ: package upstream bị làm bẩn để lợi dụng AI-assisted coding; nhóm TeamPCP/UNC6780 dùng nhiều phương pháp như hijack toolkit, prompt injection và “toxic prompt” nhằm làm mờ payload; một vụ xâm nhập bắt đầu từ personal access token bị lộ và dẫn đến triển khai hạ tầng AI trái phép. Đây là dữ kiện/tuyên bố từ nguồn Google, chưa phải thống kê đại diện toàn thị trường.
Điểm mới đáng chú ý
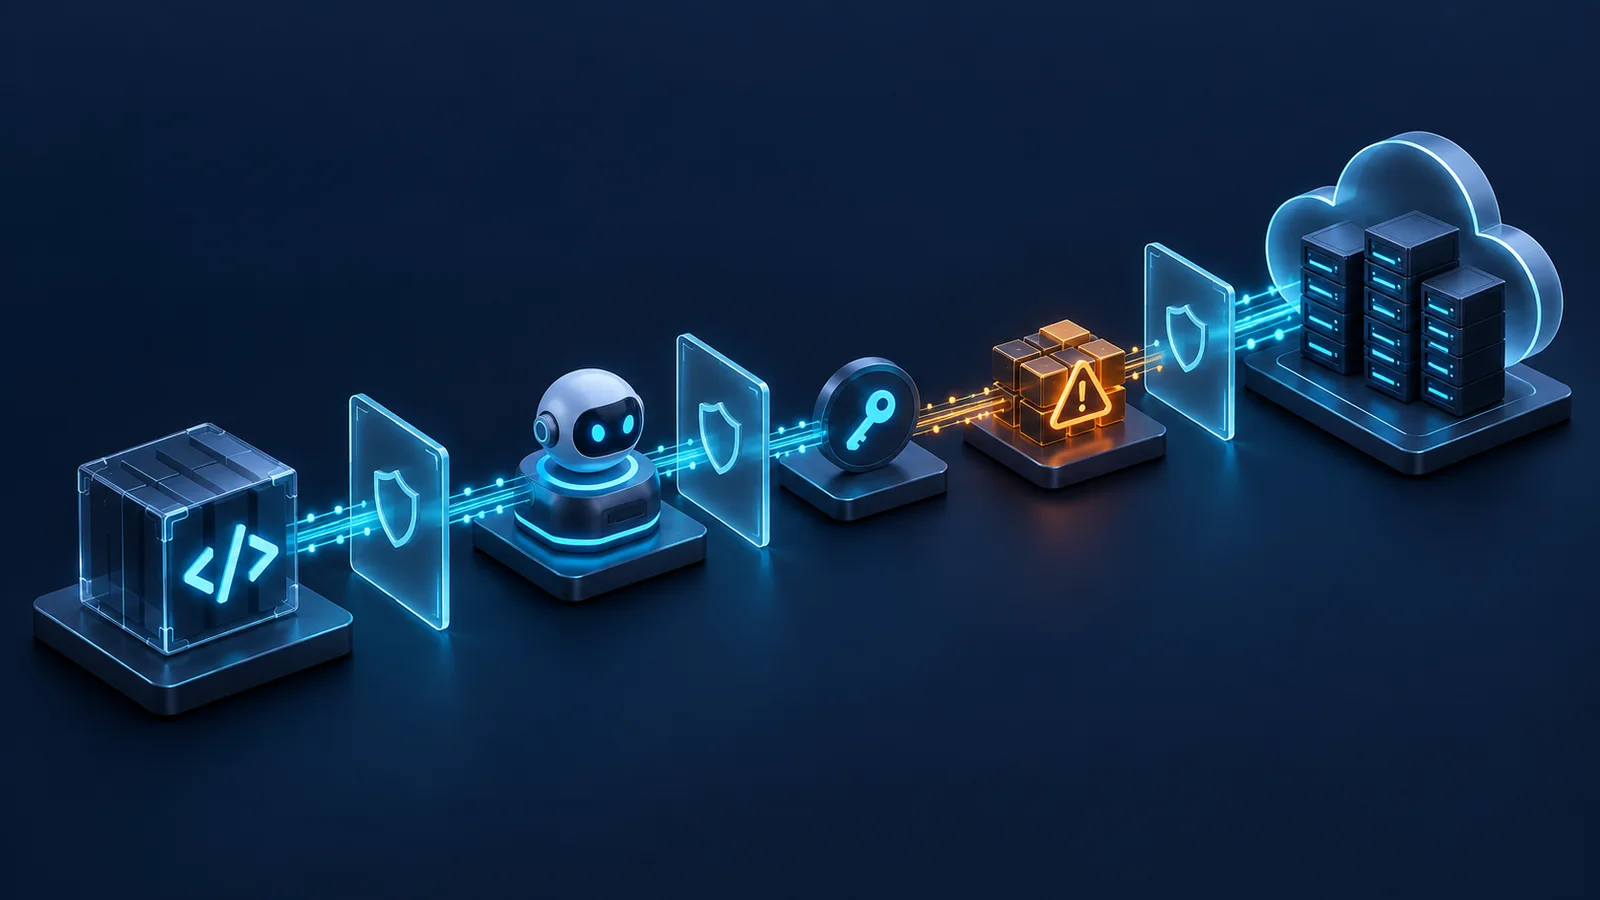
#Điểm đáng chú ý là rủi ro được nối từ code đến runtime. Package recommendation, editor/agent, CI/CD, cloud configuration, identity và compute không còn là các silo riêng. Một control chỉ nhìn repository có thể bỏ qua quyền runtime; một CSPM chỉ nhìn cloud có thể không thấy nguồn gốc thay đổi trong code hoặc prompt/tool chain.
Google cũng mô tả tác nhân liên quan PRC thử nghiệm CC Switch để luân chuyển tài khoản và model cho từng nhiệm vụ. Bài viết của hãng đề xuất multi-model và unified/dynamic graph. NetVali xem đây là giả thuyết kiến trúc cần kiểm chứng; nhiều model có thể giảm monoculture nhưng cũng tăng dependency, dữ liệu, cost và bề mặt quyền hạn.
Tác động đối với kiến trúc, vận hành và kiểm thử
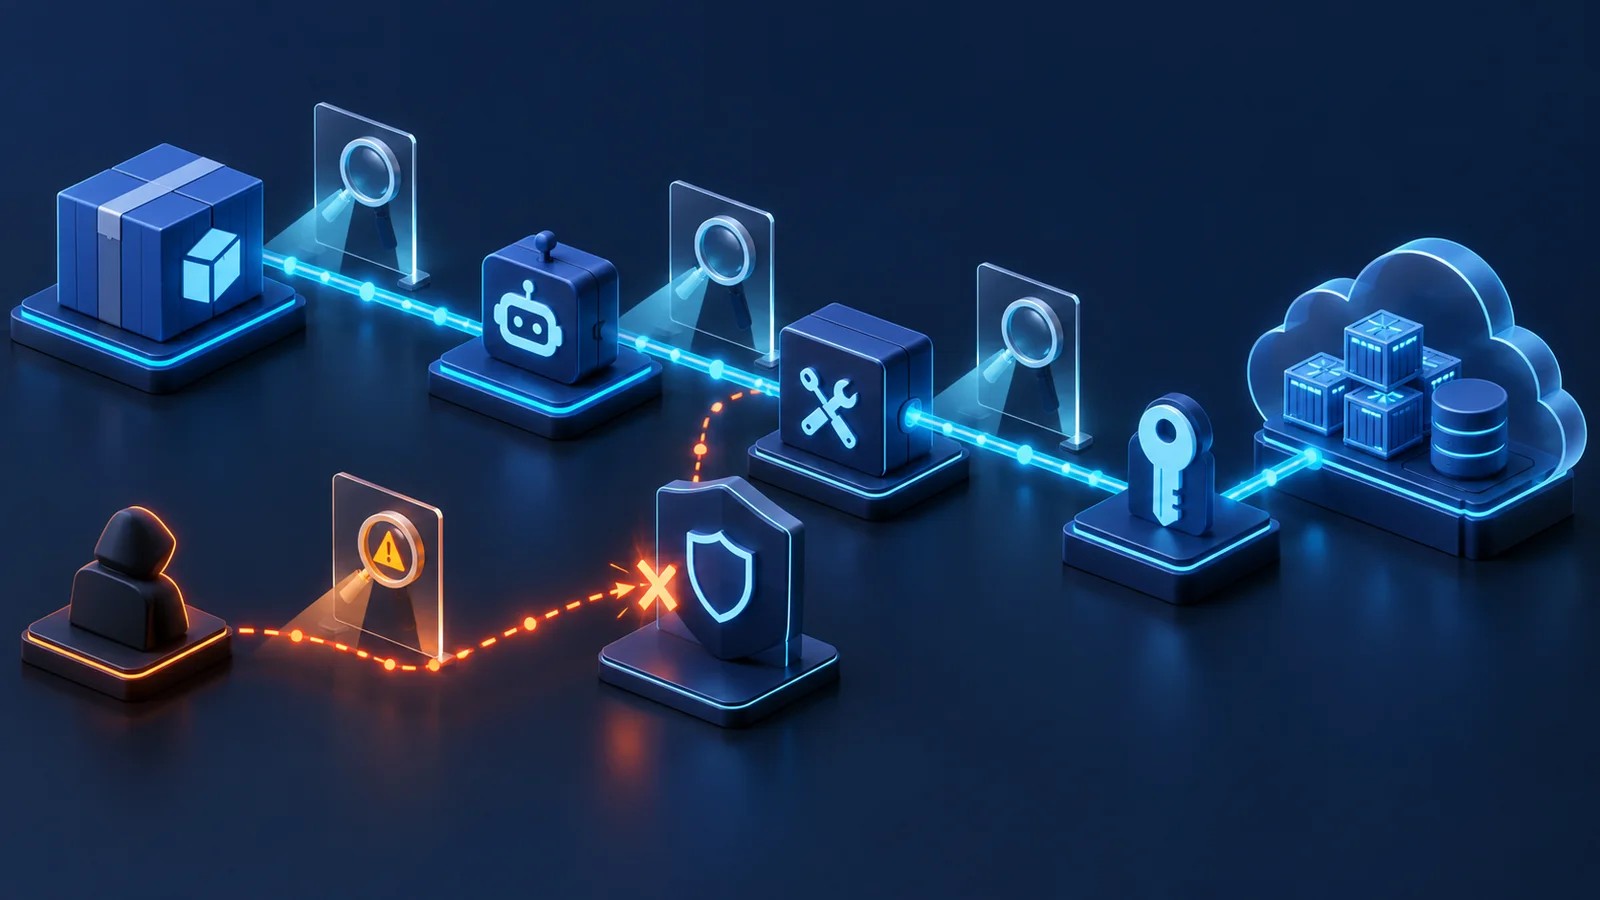
#Threat model nên bổ sung bốn đường: dependency/package → code; prompt/tool → agent action; token/workload identity → cloud resource; model/API account → compute và dữ liệu. Với mỗi đường, xác định trust boundary, privilege, logging, kill switch và bằng chứng đủ để điều tra.
Test plan không cần bắt đầu bằng “AI red team” phức tạp. Chỉ chạy trong sandbox được ủy quyền, dùng credential thử nghiệm và payload vô hại. Có thể chạy các case nhỏ: package giả tên gần giống; prompt yêu cầu gọi tool ngoài allowlist; token bị lộ nhưng đã giới hạn scope; agent cố tạo GPU/VM vượt quota; model endpoint được gọi từ identity lạ. KPI gồm prevention rate, detection latency, alert fidelity, blast radius, revoke time và recovery evidence.
- Bài toán: Package poisoning · Kịch bản kiểm chứng: Dependency trái policy xuất hiện · Bằng chứng: Lockfile, SBOM, CI gate
- Bài toán: Prompt/tool abuse · Kịch bản kiểm chứng: Agent gọi tool ngoài quyền · Bằng chứng: Trace, policy decision, deny log
- Bài toán: Token exposure · Kịch bản kiểm chứng: Dùng token từ context lạ · Bằng chứng: IAM log, revoke timeline
- Bài toán: AI compute abuse · Kịch bản kiểm chứng: Tạo workload vượt profile · Bằng chứng: API audit, quota/deny event
- Bài toán: Multi-model finding · Kịch bản kiểm chứng: So overlap và false positive · Bằng chứng: Ground-truth corpus, verdict
Ai cần quan tâm
#CISO và security architecture cần cập nhật threat model; AppSec/DevSecOps cần kiểm dependency và quyền agent trong pipeline; cloud platform cần quản token, workload identity, quota và anomalous compute; SOC cần correlation từ code đến runtime. Nhóm tài chính/FinOps cũng liên quan vì LLMjacking hoặc GPU abuse có thể tạo chi phí trước khi gây gián đoạn.
Các tổ chức chưa dùng agent tự trị vẫn cần quan tâm nếu developer dùng coding assistant hoặc workload gọi model API. Phạm vi phải dựa trên inventory thực, không mặc định mọi đội đều có cùng rủi ro.
Những điểm chưa thể kết luận
#Nguồn không cung cấp dataset đầy đủ để tính prevalence, detection rate hay mức tăng rủi ro theo ngành. Không thể suy rằng mọi supply-chain compromise năm 2025–2026 đều do AI, hoặc một kiến trúc multi-model tự động ít false positive hơn. Các tên chiến dịch và actor mapping phản ánh phân tích của Google tại thời điểm công bố.
Bài viết có nhắc cách tiếp cận/sản phẩm trong hệ sinh thái Google và Wiz; đây không phải benchmark độc lập giữa các nhà cung cấp. Hiệu quả phải được kiểm theo model, corpus, policy, integration và dữ liệu của từng tổ chức.
Checklist hành động hoặc kiểm chứng
#- Lập inventory model, agent, tool, plugin, token và workload identity.
- Gắn owner, purpose, environment, data class và quyền cho từng agent.
- Khóa dependency bằng registry policy, signature/SBOM và review thay đổi.
- Thử package giả, prompt injection và tool call ngoài allowlist trong sandbox.
- Hạn chế token scope/lifetime; kiểm secret scan và revoke time.
- Đặt quota và chính sách chặn cho GPU, VM, model API; thêm budget/anomaly alert. Budget alert không mặc nhiên là hard cap chi tiêu.
- Nối trace code–CI/CD–identity–runtime–model request.
- Dùng ground-truth corpus để đo false positive/false negative của scanner.
- Diễn tập kill switch, credential rotation và recovery sau compute abuse.
- Rà lại nguồn trước khi đăng vì threat intelligence có thể được cập nhật.
Khái niệm cần nhớ
#- Software supply chain: chuỗi dependency, build, artifact và phân phối phần mềm.
- Prompt injection: đầu vào làm lệch chỉ dẫn hoặc khiến agent thực hiện hành vi ngoài ý muốn.
- LLMjacking: chiếm quyền tài nguyên/tài khoản để chạy workload AI trái phép.
- Workload identity: danh tính máy dùng để truy cập tài nguyên.
- Blast radius: phạm vi tác động khi một control hoặc identity bị compromise.
- Ground truth: tập dữ liệu đúng đã biết để đo hiệu quả phát hiện.
Khái niệm cần nhớ
- Security efficacy
- Mức độ phát hiện hoặc ngăn chặn đúng nội dung kiểm thử trong phạm vi đã xác định.
- Goodput
- Lưu lượng ứng dụng hữu ích tới đích, không tính phần truyền lại hoặc overhead không tạo giá trị.
- False positive
- Lưu lượng hợp lệ bị nhận diện hoặc xử lý nhầm như một mối đe dọa.
TÀI LIỆU ĐỐI CHIẾUTài liệu tham khảo4 nguồn +
Nội dung được biên soạn độc lập, theo hướng vendor-neutral và đối chiếu các tài liệu gốc dưới đây. Tính năng sản phẩm cần được kiểm tra lại theo phiên bản đang sử dụng.
NetVali ưu tiên nguồn tiêu chuẩn và tài liệu chính thức; phân biệt khuyến nghị triển khai với yêu cầu của tiêu chuẩn; không công bố thông số sản phẩm chưa gắn với phiên bản và điều kiện đo.